데이터 반출 없는 다기관 연합 인공지능 학습 플랫폼

분류 전체보기 225

NP-01. 평생 쓰는 뇌, 어떻게 매일 새로워질까?

우리 뇌의 대부분을 차지하는 신경세포는 한번 만들어지면 평생 교체되지 않는다는 사실, 알고 계셨나요? 피부 세포처럼 며칠 만에 바뀌지도, 뼈세포처럼 몇 년에 걸쳐 서서히 리모델링되지도 않습니다. ​하지만 우리 몸에는 아주 특별한 '평생 건물'들이 있습니다. 한번 지어지면 거의 교체되지 않고 평생을 함께하는 세포들이죠.뇌의 신경세포 (뉴런): 우리 뇌의 핵심 일꾼들입니다. 대부분 태어날 때 함께한 세포들이 평생을 갑니다.심장 근육세포: 쉼 없이 뛰는 심장을 구성하는 세포 역시 교체율이 아주 낮습니다.눈의 수정체 세포: 세상을 보는 창문, 수정체의 세포도 한번 만들어지면 바뀌지 않아요.뇌세포는 그대로인데, 어떻게 배우고 기억할까?매일 새로운 것을 배우고, 어제와 다른 생각을 하고, 성격까지 변하는 우리의 뇌..
TR-04. 멀티-헤드 인코더-디코더 어텐션(Multi-head Encoder-Decoder Attention)

멀티-헤드 인코더-디코더 어텐션은 트랜스포머 디코더의 "두 번째 어텐션 층"에 위치하며, 디코더가 출력 단어를 생성할 때 인코더의 입력 문장 전체를 참고할 수 있게 해주는 핵심 다리 역할을 합니다. 이는 "크로스-어텐션(Cross-Attention)"이라고도 불립니다. 앞서 설명한 '셀프 어텐션'은 문장 내부의 관계를 파악하는 것이 목적이었다면, 이 '인코더-디코더 어텐션'은 서로 다른 두 문장(입력 문장과 출력 문장) 간의 관계를 파악하는 것이 목적입니다.핵심 차이점: Q, K, V의 출처가장 큰 차이점은 Query(Q), Key(K), Value(V)를 가져오는 위치입니다.Query (Q): 디코더의 이전 층(Masked Self-Attention 층)에서 옵니다. 의미: "내가 지금 번역/생성하려는..

두 벡터의 내적의 분산 구하기

1. 문제의 전제 조건 정의먼저, 우리가 가진 조건들을 수학적으로 정리해 보겠습니다.$n$차원의 두 벡터 $\mathbf{a}$와 $\mathbf{b}$가 있습니다. $\mathbf{a} = (a_1, a_2, \ldots, a_n)$$\mathbf{b} = (b_1, b_2, \ldots, b_n)$각 벡터의 성분 $a_i$와 $b_j$는 모두 독립적인 확률 변수라고 가정합니다. (이 가정이 매우 중요합니다!)각 성분의 평균(기대값)은 0입니다. $E[a_i] = 0$ (모든 $i$에 대해)$E[b_i] = 0$ (모든 $i$에 대해)각 성분의 분산은 1입니다. $Var(a_i) = 1$ (모든 $i$에 대해)$Var(b_i) = 1$ (모든 $i$에 대해)2. 목표: 내적의 분산우리가 구하려는 것은 ..

데이터 시각화 핵심 방법론 및 원칙

데이터를 단순히 나열하는 것을 넘어, 숨겨진 의미와 스토리를 발견하고 효과적으로 전달하기 위한 데이터 시각화. 세계적인 전문가 3인의 핵심 이론을 통해 그 방법론과 원칙을 소개합니다.1. 벤 프라이 (Ben Fry): 데이터에서 인사이트까지의 여정"데이터를 의미 있는 정보로 시각화하는 체계적인 7단계 프로세스" 벤 프라이는 데이터를 수집하는 것부터 사용자와 상호작용하는 최종 결과물에 이르기까지, 전 과정을 7개의 논리적 단계로 정의했습니다. 이 방법론을 따르면 데이터의 잠재력을 최대한 이끌어낼 수 있습니다.획득 (Acquire): 원석(데이터)을 모으는 단계 설명: 시각화의 대상이 될 데이터를 수집합니다. 데이터는 파일, 데이터베이스, 웹 API 등 다양한 형태로 존재할 수 있습니다. 예시: 온라인 쇼핑..

데이터 시각화 유형

데이터가 넘쳐나는 시대에, 숫자 그 자체만으로는 숨겨진 의미를 파악하기 어렵습니다. 데이터 시각화는 복잡한 데이터를 이해하기 쉬운 이미지로 변환하여 인사이트를 발견하고, 설득력 있는 이야기를 전달하는 가장 강력한 도구입니다. 이 문서는 효과적인 데이터 시각화를 위해 알아야 할 핵심 유형을 소개합니다. 어떤 차트를 선택해야 할지 고민된다면, 데이터로 무엇을 보여주고 싶은지 먼저 자문해보세요. 항목 간의 '비교'가 중요한가요? 변수 간의 '관계'를 찾고 있나요? 데이터의 '분포'를 파악하고 싶나요? 아니면 전체에 대한 각 부분의 '구성' 비율을 보여줘야 하나요? 이 질문에 따라 가장 효과적인 시각화 유형이 결정됩니다.시간 시각화 (Temporal Visualization)시간의 흐름에 따른 데이터 변화를 표..

로지스틱 회귀: 오즈(Odds)와 오즈비(Odds Ratio)

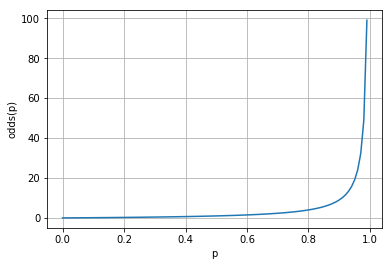
로지스틱 회귀 분석을 이해하는 데 가장 기본이 되는 오즈(Odds)와 오즈비(Odds Ratio)에 대해 자세히 설명해 드리겠습니다. 이 두 개념은 확률(Probability)을 통계 모델(특히, 선형 모델)에서 더 다루기 쉬운 형태로 변환하고, 그 결과를 해석하는 데 핵심적인 역할을 합니다.1. 오즈 (Odds)오즈(Odds)는 "어떤 일이 일어나지 않을 확률 대비 일어날 확률의 비율"을 의미합니다.확률(Probability)과의 차이:확률 (P): 전체 시도 중 특정 사건이 일어날 비율 ($P$). 범위: [0, 1]오즈 (Odds): 실패 확률 대비 성공 확률의 비율. 범위: [0, $\infty$]수식: 어떤 사건이 일어날 확률을 $P$라고 할 때, 오즈는 다음과 같이 계산됩니다.$$Odds = ..

로지스틱 회귀: 오즈, 로짓 함수, 로지스틱 함수의 관계

오즈, 로짓 함수, 로지스틱 함수는 로지스틱 회귀가 선형 모델의 결과를 (0, 1) 사이의 확률로 어떻게 변환하는지를 보여주는 중요한 요소들입니다.1. 오즈 (Odds)오즈는 어떤 사건이 일어날 확률을 일어나지 않을 확률로 나눈 값입니다. 확률과 비슷한 개념이지만, 표현 방식이 다릅니다.확률 ($p$): 전체 시도 중 특정 사건이 일어날 비율 (0과 1 사이의 값)오즈: 성공 확률과 실패 확률의 비율 (0과 무한대 사이의 값)수식으로 표현하면 다음과 같습니다.$$\text{Odds} = \frac{p}{1-p}$$여기서 $p$는 사건이 일어날 확률입니다. 예시어떤 팀의 경기 승리 확률($p$)이 80% (0.8)라고 가정해 보겠습니다.승리하지 못할 확률($1-p$)은 20% (0.2)입니다.이때 오즈는 ..

로지스틱 회귀: 모델, 비용 함수, 파라미터 찾기

1. 문제 정의1.1. 데이터셋로지스틱 회귀에 대한 이해를 돕기 위하여 다음과 같이 두 종류의 데이터셋을 준비하고 설명을 진행합니다.Dataset-A: $$\begin{flalign} x&=\left[1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20 \right] \\ y&=[0,0,0,0,0,0,0,0,0,0,1,1,1,1,1,1,1,1,1,1] \end{flalign}$$Dataset-B: $$\begin{flalign} x&=\left[1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20 \right] \\ y&=[0,0,0,1,1,0,1,0,1,1,1,1,1,1,1,1,1,1,1,1] \end{flalign}$$위에서 ..

확률(Probability)과 우도(Likelihood): 명확한 개념 비교

통계학을 공부할 때 가장 혼동하기 쉬운 개념 중 하나가 바로 확률(Probability)과 우도(Likelihood)입니다. 두 용어는 일상적으로 비슷하게 사용되지만, 통계적 추론의 세계에서는 근본적으로 다른 관점을 가집니다. 예시를 통한 개념 비교:확률 (모수로부터 관찰값 추정): 상황: 불투명한 주머니 속에 노란공 6개, 파란공 4개가 들어 있다는 사실을 알고 있다. 질문: 한 개의 공을 꺼낼 때 노란공일 가능성은? 우도 (관찰값으로부터 모수 추정):상황: 불투명한 주머니 속에 노란공과 파란공이 함께 들어 있다는 사실을 알고는 있지만 몇 개씩인지는 모른다.질문: 한 개의 공을 꺼냈다가 다시 집어 넣는 동작을 10번 반복했더니 노란공이 4번 나왔다. 그렇다면 주머니 속 노란공과 파란공의 비율이 4:6일..

DistilBERT + KorQuAD MLM 훈련 소요 시간 비교 (RTX 4090, T4, A100)

개요BERT 계열 언어 모델 중 하나인 DistilBERT(논문)로 미세 조정 훈련을 수행할 때 NVIDIA GPU 모델에 따라 훈련에 걸리는 시간이 어떻게 달라지는지 궁금했습니다. 실험에 사용한 모델과 데이터셋은 다음과 같습니다.기본 모델: distilbert-base-multilingual-cased데이터셋: KorQuAD 1.0미세 조정 훈련은 아래의 작업을 목표로 하였습니다.Masked Language Model (MLM) (참고: Fine-tuning a masked language model)GPU 모델 사양훈련 소요 시간 비교를 위해 사용한 NVIDIA GPU 모델은 아래 표와 같습니다.GPU 모델RTX 4090T4A100 (40GB 기준)CUDA 코어 수16,384개2,560개6,912개T..