데이터 반출 없는 다기관 연합 인공지능 학습 플랫폼

데이터 분석/가설 검정 7

‘신뢰구간 95%’의 올바른 이해와 흔한 오해

통계학이나 데이터 분석을 공부하다 보면 "95%의 확률", "95% 신뢰구간"이라는 표현을 수없이 접하게 됩니다. 언뜻 보면 직관적이고 쉬워 보이지만, 실상 통계학 전공자나 현업 데이터 분석가들조차 말로 설명하려 할 때 가장 많이 말문이 막히거나 논리적 오류를 범하는 개념 중 하나가 바로 이 ‘신뢰구간(Confidence Interval)’입니다. 이번 글에서는 신뢰구간을 공부할 때 흔히 빠지는 오해의 문장을 살펴보고, 왜 그 해석이 잘못되었는지, 그리고 어떻게 이해해야 통계학적 결점 없이 본질을 파악할 수 있는지 차근차근 짚어보겠습니다.1. 흔히 마주치는 '그럴듯한' 오해신뢰구간 95%의 의미를 직관적으로 정리하려다 보면 다음과 같은 흐름으로 생각하기 쉽습니다.표본 추출을 100회 반복한다.표본 1로부..
‘신뢰구간 95%’ vs ‘95% 확률 구간’

통계학이나 머신러닝, 데이터 분석을 공부하다 보면 "95%의 확률"이라는 표현을 자주 접하게 됩니다. 그중에서도 가장 많은 오해를 낳는 조합이 바로 통계적 추정에서 쓰이는 신뢰구간(Confidence Interval) 95%와, 주어진 분포에서 특정 영역을 나타내는 95% 확률 구간(Probability Interval)입니다. 두 개념은 모두 '95%'라는 친숙한 숫자를 다루지만, 무엇을 확률적인 대상(변수)으로 보는지, 그리고 모수를 고정된 상수로 보는지 확률변수로 보는지에 대한 관점부터 완전히 다릅니다. 이 둘의 명확한 차이와 올바른 해석법을 알기 쉽게 정리해 보겠습니다.1. 신뢰구간 95% (95% Confidence Interval)개념 정의신뢰구간은 표본 데이터를 기반으로 모집단의 알려지지 않..

카이제곱 분포와 표본 분산의 관계

핵심 요약:1) 서로 독립인 표준정규확률변수$n$개의 제곱을 합하면 자유도가 $n$인 카이제곱 분포를 따릅니다.2) 정규분포 $N(\mu, \sigma^2)$를 따르는 모집단으로부터 크기가 $n$인 표본 하나를 추출하면 $$\sum_{i=1}^n \frac{(X_i - \bar{X})^2}{\sigma^2}$$ $X_i$: 표본의 $i$번째 값 $\bar{X}$: 표본평균은 자유도가 $n-1$인 카이제곱 분포를 따릅니다.3) 이 관계를 활용하여 표본분산으로부터 모분산의 신뢰구간을 계산하거나 가설검정을 수행할 수 있습니다. 카이제곱 분포(\(\chi^2\) distribution)와 표본 분산(sample variance)의 관계를 이해하는 핵심은 정규분포를 따르는 모집단에서 표본을 추출하면, ..

효과 크기(effect size) 두 지표—η²(에타제곱)와 Cramér's V

1. 에타 제곱 ($\eta^2$, Eta-squared)에타 제곱은 주로 분산분석(ANOVA)에서 사용되는 지표로, 독립 변수가 종속 변수의 전체 분산 중 얼마만큼을 설명하는지를 나타냅니다.① 직관적 의미"전체 변동 중에서 우리가 관심 있는 요인(집단 간 차이)이 차지하는 비중이 얼마나 되는가?"를 의미합니다. 예를 들어, 세 가지 다른 학습법이 성적에 미치는 영향을 조사할 때, 성적 차이(분산)가 발생한 원인 중 '학습법의 차이' 때문에 발생한 비율이 바로 $\eta^2$입니다.② 수식$$\eta^2 = \frac{SS_{between}}{SS_{total}}$$$SS_{between}$ (Sum of Squares Between groups): 집단 간 제곱합 (집단 간의 차이로 인한 변동)$SS_..

가설 검정 이해하기

1. 문제 정의1.1. 사례기존 가설: 20 대 한국인 남성의 100 미터 달리기 평균 속도는 17 초새로운 실험 결과: 무작위로 추출한 20 대 한국인 남성 500 명의 100 미터 달리기 평균 속도는 16 초위 사례에서 새로운 실험 결과가 우연히 일어났다고 보는 것이 적절할까요 아니면 가설이 유효하지 않은걸까요? 정답이 존재하지 않는 이런 종류의 문제를 다루기 위해서는 차이가 얼마나 의미있는지 표현하는 객관적인 방법이 있어야 하지 않을까요?1.2. 문제기존 가설과 새로운 실험의 결과가 양립하는 정도를 체계적인 과정을 통해 숫자로 표현하는 방법은 무엇인가?2. 용어 정리2.1. 출처: 위키백과, WIKIPEDIA통계적 추론추론 통계 또는 추론 통계학(inferential statistics)으로 불린다..

독일 V2 로켓과 런던 폭격 - 푸아송 분포와 카이제곱 검정

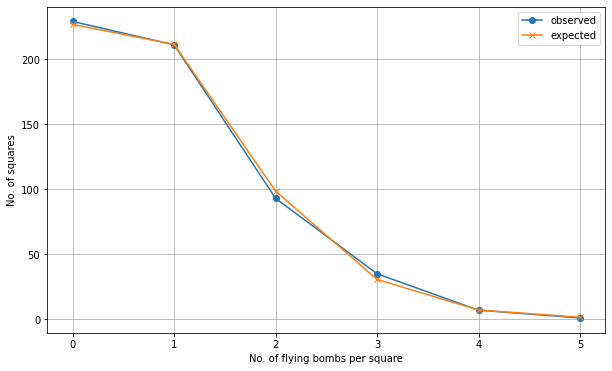
아래 자료들을 참고하면서 실습을 하였습니다.AN APPLICATION OF THE POISSON DISTRIBUTION, by R. D. CLARKEThe flying bomb and the actuary - Royal Statistical Society, Wiley푸아송 분포실제값n_squares = 576n_bombs = 537# 구역당 떨어진 폭탄 수의 평균m = n_bombs / n_squaresprint(f'{m:.3f}')0.932# 구역당 떨어진 폭탄 수n_bombs_per_square = [0, 1, 2, 3, 4, 5]# 해당 구역 수 (관찰도수)observed_num_of_squares = [229, 211, 93, 35, 7, 1]print(f'# of squares: {sum(obs..

독일 V2 로켓과 런던 폭격 - 푸아송 분포 응용

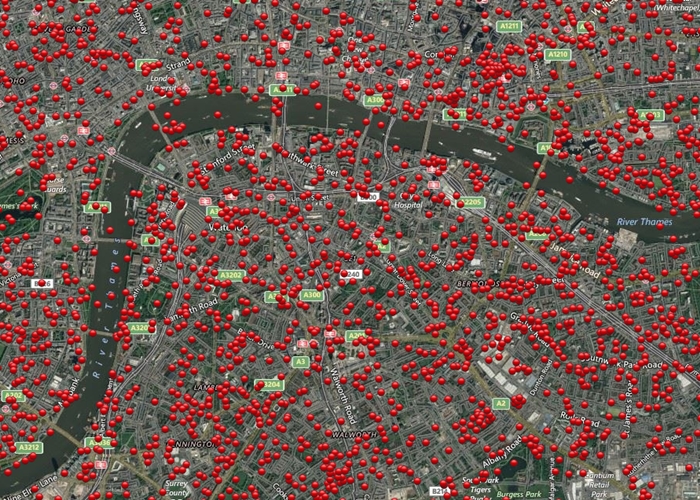
관심을 가졌던 사항은 2차 세계 대전 말기 독일 V2 로켓에 의한 런던 폭격 지점의 분포와 푸아송 분포 응용 사례였는데 우연히 접한 기사를 흥미있게 읽다가 오류로 의심되는 부분을 발견하고 이를 확인하는 과정에서 글을 쓰게 되었습니다.기사 인용- [문학이 사랑한 통계⑬] 로저 멕시코와 함께하는 확률론 강의, 2019.01.03, 시사위크도서 내용 중 일부 - 토머스 핀천, 중력의 무지개, 이상국 옮김, 새물결로저는 그녀에게 V폭탄의 통계에 대해 애써 설명했다. 천사의 눈에나 보일 영국 지도 안의 분포와 이 아래 인간의 눈에 보이는, 그들 자신이 살아남을 기회의 차이에 대해.“그러나 이미 폭격을 몇 번이나 받은 곳도 있잖아. 그러니까-” “미안하지만 그게 바로 몬테카를로 오류라는 거야. 특정한 지역에 얼마나..